

Infrastruktura NVIDIA GB200 NVL72 i okablowanie MPO-8 APC dla jednostek skalowalnych
Analiza architektury okablowania skalowalnej jednostki Blackwell (SU), gdzie 8 szaf łączy się w 9 216 aktywnych włókien światłowodowych.
Skalowalna jednostka DGX GB200 (SU) stanowi dużą zmianę w architekturze centrów danych. SU to zunifikowana jednostka z 576 procesorami graficznymi, połączona za pomocą 9 216 aktywnych włókien światłowodowych. ScaleFibre dostarcza precyzyjnie zarobione kable trunk, niezbędne do zarządzania tą gęstością.
Cztery fizyczne sieci SuperPOD
NVIDIA dzieli SU na odrębne warstwy fizyczne w celu izolacji ruchu GPU.
MN-NVL (NVLink 5)
Skalowanie w górę„Wewnętrzna” sieć szafy łącząca 72 procesory graficzne z prędkością 1,8 TB/s.
- Zero włókien optycznych
- Pasywna miedziana płyta montażowa (backplane)
- Złącza typu „blind-mate”
InfiniBand obliczeniowy
Skalowanie w poziomieGłówna sieć „Wschód-Zachód” do masowego szkolenia wielowęzłowego.
- 4 608 aktywnych włókien na SU
- Topologia zoptymalizowana pod kątem szyn
- Quantum-3/Quantum-2
Pamięć masowa i In-Band
FrontendSieć oparta na Ethernet do szybkiego pozyskiwania i udostępniania danych.
- Współczynnik blokowania 5:3
- Odciążanie DPU BlueField-3
- Obsługa VXLAN/RoCE
Zarządzanie OOB
Płaszczyzna sterowaniaIzolowana sieć do telemetrii sprzętu, zarządzania BMC i PDU.
- Miedź RJ45/Cat6
- Warstwa przełączników SN2201
- Bezpieczeństwo dzięki fizycznej separacji (air gap)
Metryki Exascale SU
8-szafowa jednostka skalowalna stanowi podstawowy element konstrukcyjny fabryki sztucznej inteligencji NVIDIA.
9 216
Aktywne włókna na SU4 608
Włókna wyłącznie obliczeniowe5:3
Współczynnik blokowania pamięci masowej400G/800G
Natywne prędkości portów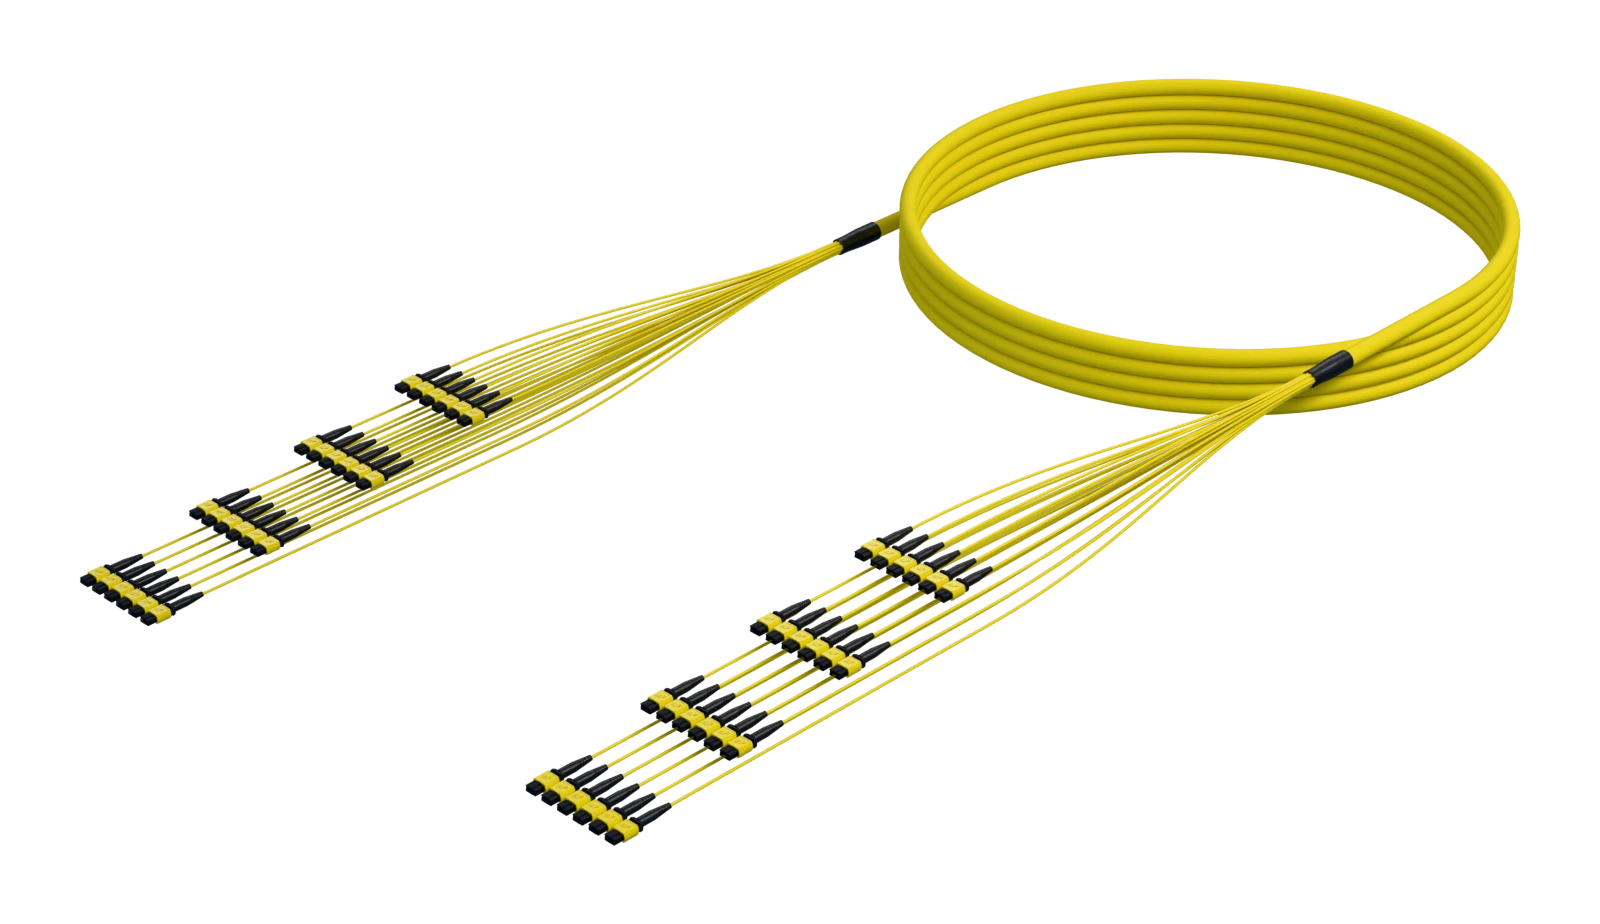
Kable magistralne MPO o dużej liczbie włókien
Zestawy magistrali MPO o dużej liczbie włókien, zawierające od 48 do 576 włókien. Umożliwiają szybkie wdrożenie na dużą skalę przy mniejszym nakładzie pracy i minimalnych kosztach instalacji.
Zobacz szczegóły kabli trunk MPO o dużej liczbie włókienTrzy poziomy łączności SU
Poziom A: Serwer-do-Leaf
1 152 włókna na szafę, wykorzystujące kable trunk o dużej liczbie włókien lub patchcordy do łączenia węzłów NVL72 z przełącznikami Leaf.
Poziom B: Leaf-do-Spine
Agregacja ruchu zgodnego z szynami w obrębie SU za pomocą łączy 1:1 bez blokowania dla obliczeń.
Poziom C: Spine-do-Core
Skalowanie poza SU do scentralizowanego obszaru rdzenia za pomocą kabli trunk o dużej liczbie włókien.
Tradycyjne połączenia krosowe (punkt-punkt)
- ✕Złożoność ręczna: Wymaga 9 216 pojedynczych patchcordów na blok 8 szaf.
- ✕Zablokowanie przepływu powietrza: Gęste wiązki kabli blokują drogi odprowadzania ciepła z chłodzenia cieczą.
- ✕Profil ryzyka: Wysokie prawdopodobieństwo „skrzyżowanych szyn” podczas ręcznego połączenia 1:1.
- ✕Czas wdrożenia: Ponad 115 godzin na ręczne prowadzenie i etykietowanie na SU.
Modułowe okablowanie trunk o dużej liczbie włókien
- ✓Plug-and-Play: Konsoliduje tysiące włókien w wstępnie zarobione, dostosowane kable trunk 128F/144F/256F/288F/576F.
- ✓Optymalizacja termiczna: Kable o małej średnicy maksymalizują przepływ powietrza w gęsto upakowanych szafach.
- ✓Efektywność trasowania: Konsoliduje 1 152 aktywne włókna na szafę w kable trunk MPO o dużej liczbie włókien.
- ✓Profil instalacji: Szybkie wdrożenie dzięki wstępnie zarobionym, fabrycznie testowanym zestawom.
Wzrost aktywnych włókien: od węzła do pełnego SuperPOD
Złożoność okablowaniaWizualizacja jednostki skalowalnej
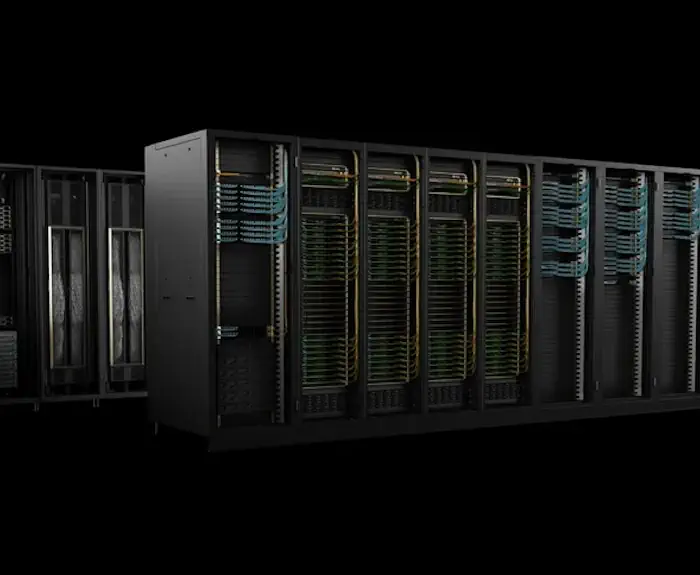
8-szafowy blok obliczeniowy
NVIDIA GB200 SU (Scalable Unit) składa się z 8 szaf, z których każda mieści system DGX GB200 NVL72 z 72 procesorami graficznymi.
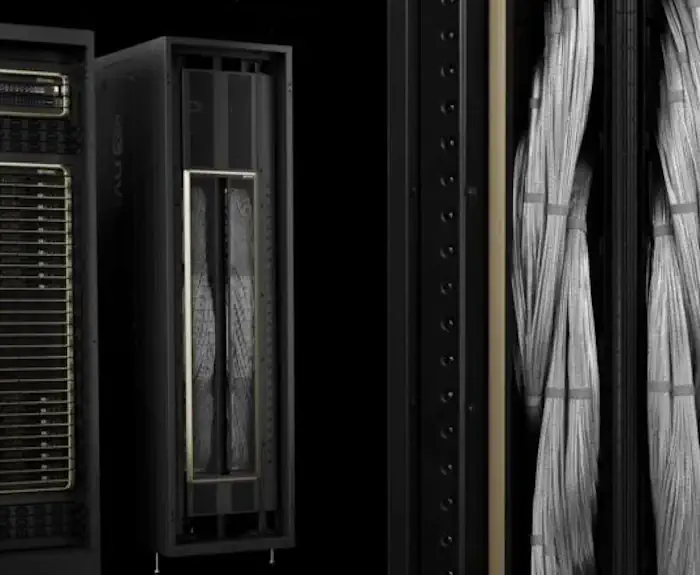
Dystrybucja kabli trunk o dużej liczbie włókien
Konsolidacja tysięcy włókien szafowych w kable trunk o wysokiej gęstości w celu zapewnienia swobodnego przepływu powietrza, szybkiej instalacji i minimalnego wykorzystania tras kablowych.
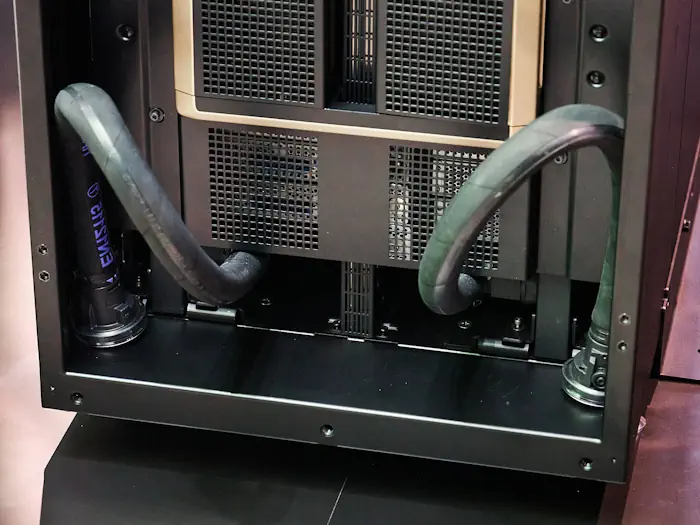
Chłodzenie cieczą
Płyty chłodzące cieczą stabilizują środowisko tacy, umożliwiając transceiverom OSFP efektywne odprowadzanie ciepła za pomocą radiatorów.
Techniczne FAQ
Zaprojektuj swoją fabrykę AI
ScaleFibre dostarcza wstępnie zarobione rozwiązania kablowe dla wdrożeń NVIDIA DGX SuperPOD.
Skontaktuj się z namiUzyskaj szczegółowe informacje na temat kabli trunk o dużej liczbie włókien dla Twojej jednostki NVIDIA DGX SU.