

Infrastruttura NVIDIA GB200 NVL72 e cablaggio MPO-8 APC per le Scalable Unit
Analisi dell'architettura di cablaggio di una Scalable Unit (SU) Blackwell, in cui 8 rack convergono in 9.216 fibre attive.
La Scalable Unit (SU) DGX GB200 rappresenta una svolta importante nell’architettura dei data center. La SU è un’entità unificata da 576 GPU interconnesse da 9.216 fibre attive. ScaleFibre fornisce i trunk terminati con precisione necessari per gestire questa densità.
Le 4 fabric fisiche del SuperPOD
NVIDIA suddivide la SU in livelli fisici distinti per isolare il traffico delle GPU.
MN-NVL (NVLink 5)
Scale-upLa rete ‘interna’ del rack che collega 72 GPU a 1,8 TB/s.
- Zero fibra ottica
- Backplane passivo in rame
- Connettori blind-mate
InfiniBand di calcolo
Scale-outLa fabric ’est-ovest’ principale per l’addestramento multinodo su larga scala.
- 4.608 fibre attive per SU
- Topologia ottimizzata per rail
- Quantum-3/Quantum-2
Storage e in-band
FrontendFabric basata su Ethernet per l’acquisizione e il provisioning dei dati ad alta velocità.
- Fattore di blocking 5:3
- Offload su DPU BlueField-3
- Supporto VXLAN/RoCE
Gestione OOB
Control planeLa rete isolata per telemetria hardware, BMC e gestione delle PDU.
- Rame RJ45/Cat6
- Livello di switch SN2201
- Sicurezza tramite isolamento fisico (air gap)
Metriche della SU exascale
Una Scalable Unit da 8 rack rappresenta l'elemento costitutivo fondamentale dell'AI Factory di NVIDIA.
9.216
Fibre attive per SU4.608
Fibre dedicate solo al calcolo5:3
Rapporto di blocking dello storage400G/800G
Velocità native delle porte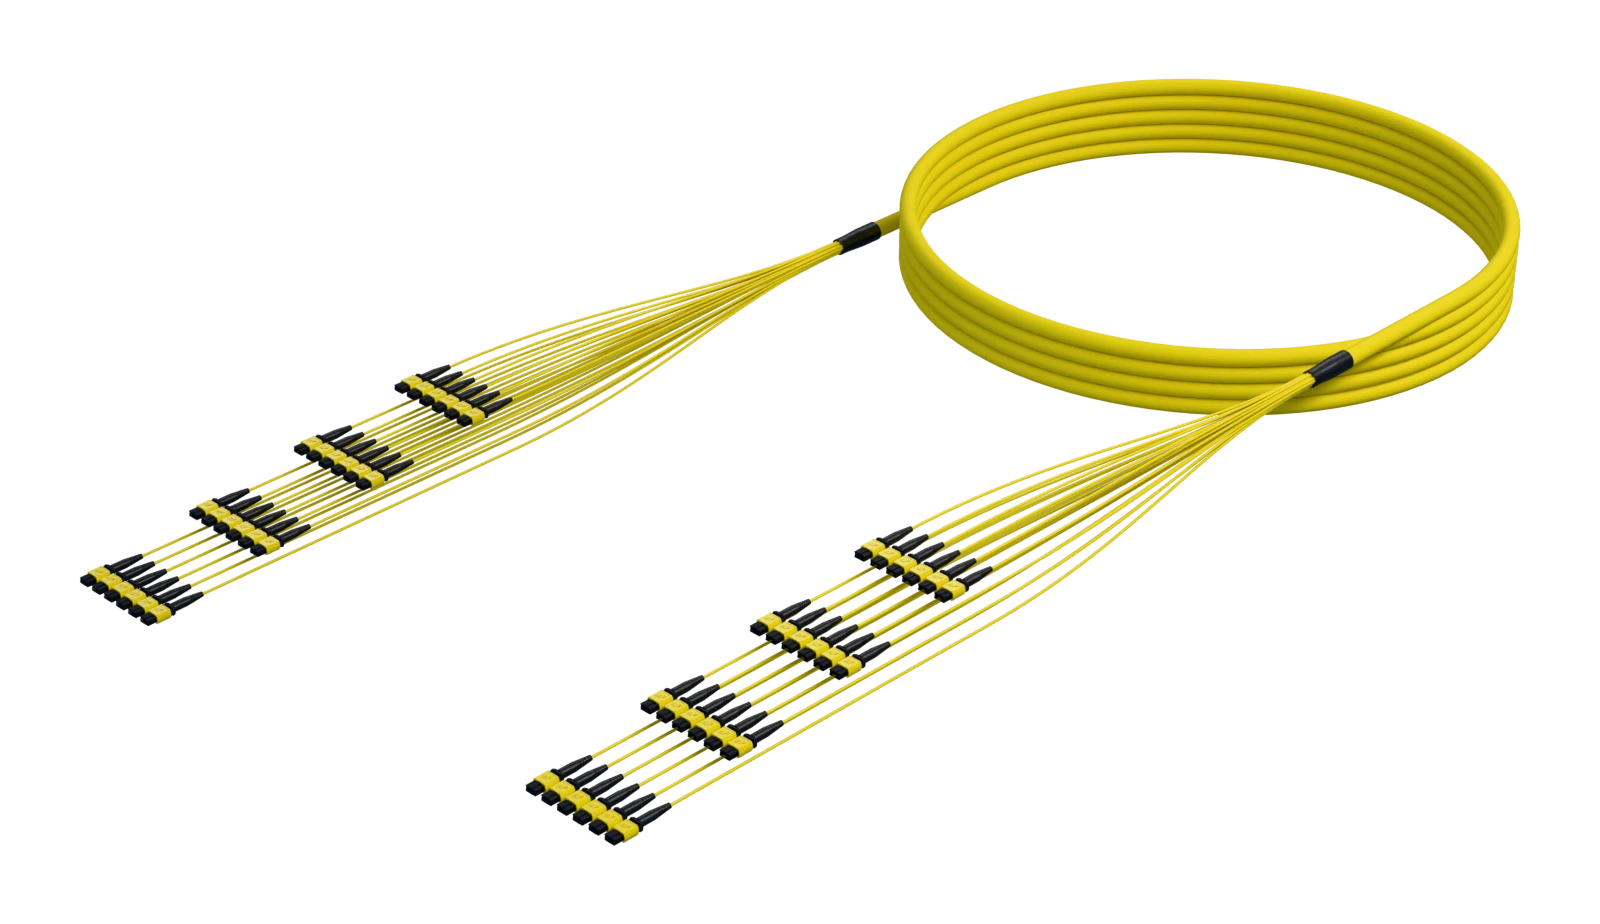
Cavi trunk MPO ad alto numero di fibre
Assemblaggi trunk MPO ad alto numero di fibre, da 48 a 576 fibre. Consentono un'implementazione rapida e su larga scala con manodopera ridotta e costi di installazione minimi.
Vedi i dettagli dei trunk MPO ad alto numero di fibreI tre livelli di connettività della SU
Livello A: server-leaf
1.152 fibre per rack tramite trunk o jumper ad alto numero di fibre per collegare i nodi NVL72 agli switch leaf.
Livello B: leaf-spine
Aggregazione del traffico allineato ai rail all’interno della SU tramite collegamenti 1:1 non bloccanti per il calcolo.
Livello C: spine-core
Scalabilità oltre la SU verso un’area core centralizzata tramite trunk ad alto numero di fibre.
Patching tradizionale (punto-punto)
- ✕Complessità manuale: richiede 9.216 bretelle singole per ogni blocco da 8 rack.
- ✕Ostruzione del flusso d’aria: i fasci di cavi densi bloccano i percorsi di scarico del raffreddamento a liquido.
- ✕Profilo di rischio: elevata probabilità di ‘rail incrociati’ durante il patching manuale 1:1.
- ✕Tempi di installazione: oltre 115 ore per instradamento ed etichettatura manuali per ogni SU.
Trunk modulari ad alto numero di fibre
- ✓Plug-and-play: consolida migliaia di fibre in trunk preterminati su misura da 128F/144F/256F/288F/576F.
- ✓Ottimizzazione termica: i cavi di diametro ridotto massimizzano il flusso d’aria nei rack ad alta densità.
- ✓Efficienza dei percorsi: consolida 1.152 fibre attive per rack in dorsali MPO ad alto numero di fibre.
- ✓Profilo di installazione: implementazione rapida tramite assemblaggi preterminati e testati in fabbrica.
Crescita delle fibre attive: dal nodo al SuperPOD completo
Complessità del cablaggioLa Scalable Unit in dettaglio
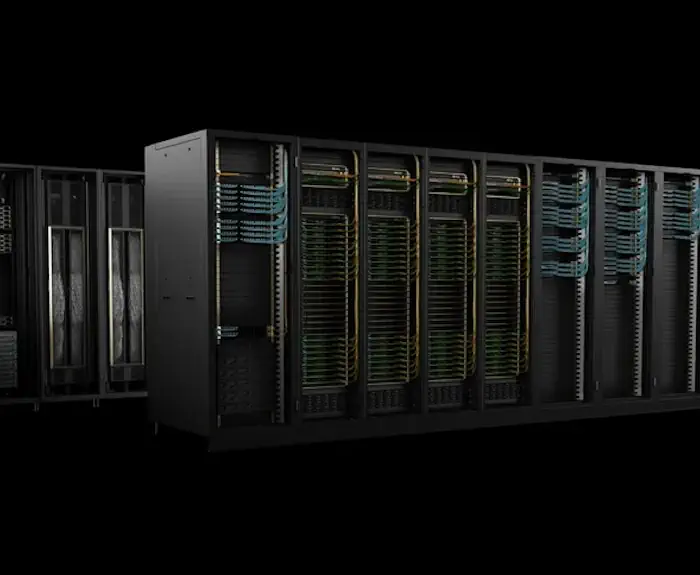
Il blocco di calcolo da 8 rack
Una SU (Scalable Unit) NVIDIA GB200 è composta da 8 rack, ciascuno dei quali ospita un sistema DGX GB200 NVL72 con 72 GPU.
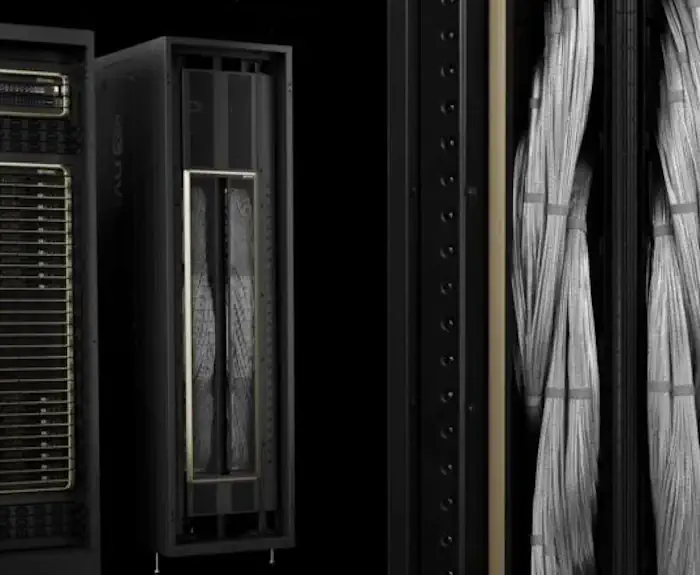
Distribuzione con trunk ad alto numero di fibre
Consolidamento di migliaia di fibre dei rack in trunk ad alta densità per liberare il flusso d’aria, velocizzare l’installazione e ridurre al minimo l’occupazione dei percorsi.
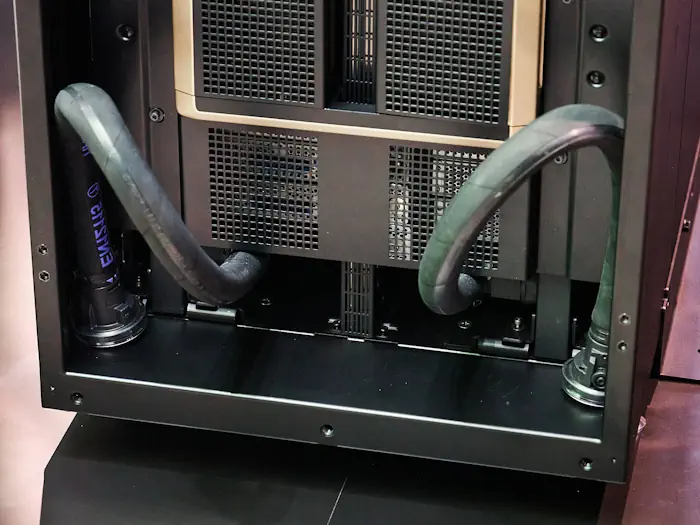
Raffreddamento a liquido
Le piastre fredde raffreddate a liquido stabilizzano l’ambiente del tray, consentendo ai transceiver OSFP di dissipare efficacemente il calore tramite dissipatori integrati.
FAQ tecniche
Progettate la vostra AI Factory
ScaleFibre fornisce soluzioni di cablaggio preterminato per le implementazioni NVIDIA DGX SuperPOD.
ContattateciRichiedete i dettagli sui trunk ad alto numero di fibre per la vostra SU NVIDIA DGX.