

NVIDIA GB200 NVL72 Infrastruktur og MPO-8 APC Kabeltrækning til Skalerbare Enheder
Dekomponering af kablingsarkitekturen i en Blackwell Scalable Unit (SU), hvor 8 racks konvergerer til 9.216 aktive fiberstrenge.
DGX GB200 Scalable Unit (SU) repræsenterer et stort skift i datacenterarkitekturen. SU’en er en forenet 576-GPU-enhed sammenkoblet af 9.216 aktive fiberstrenge. ScaleFibre leverer de præcisionsterminerede trunks, der kræves for at håndtere denne tæthed.
De 4 fysiske SuperPOD-fabrics
NVIDIA segmenterer SU i forskellige fysiske lag for at isolere GPU-trafik.
MN-NVL (NVLink 5)
Scale-UpDet ‘interne’ rack-netværk, der forbinder 72 GPU’er med 1,8 TB/s.
- Nul Optisk Fiber
- Passiv Kobber Backplane
- Blind-mate konnektorer
Compute InfiniBand
Scale-OutDet primære ‘Øst-Vest’-fabric til massiv multi-node træning.
- 4.608 aktive fibre pr. SU
- Skinne-optimeret topologi
- Quantum-3/Quantum-2
Lager & In-Band
FrontendEthernet-baseret fabric til høj hastigheds dataindtagelse og provisionering.
- 5:3 Blokeringsfaktor
- BlueField-3 DPU offload
- VXLAN/RoCE support
OOB Management
KontrolplanDet isolerede netværk til hardware telemetri, BMC og PDU management.
- RJ45/Cat6 Kobber
- SN2201 Switch-tier
- Fysisk air-gap sikkerhed
Exascale SU Metrikker
En 8-rack Scalable Unit repræsenterer den grundlæggende byggesten i NVIDIA AI Factory.
9.216
Aktive Fibre pr. SU4.608
Kun Compute-strenge5:3
Lagerblokeringsforhold400G/800G
Native Port Hastigheder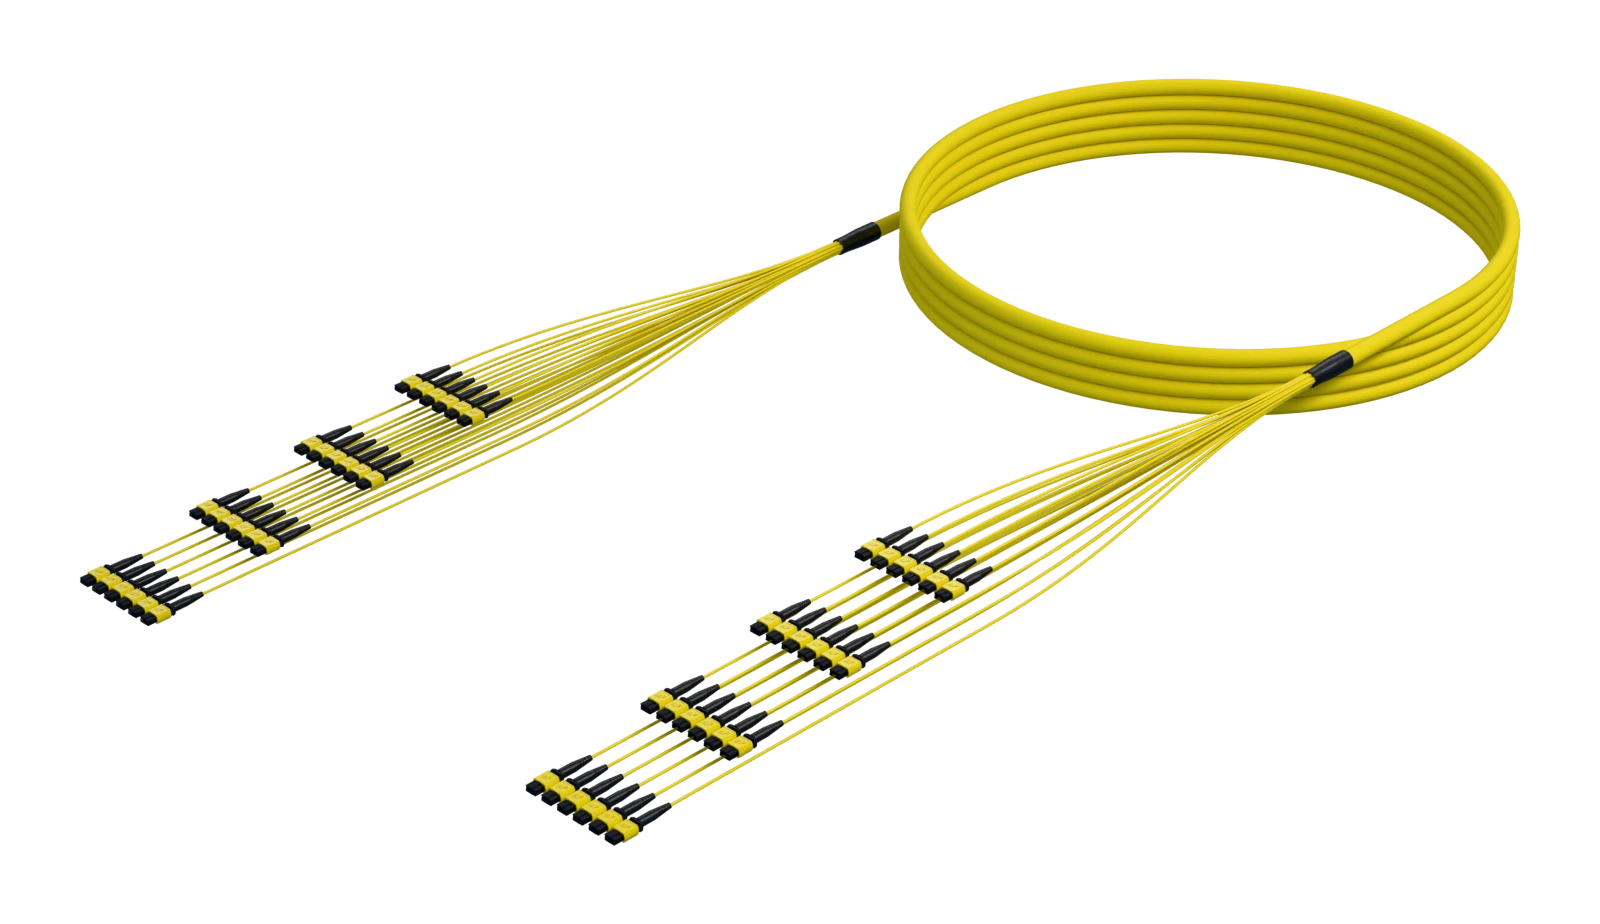
MPO-trunkkabler med højt fiberantal
MPO-trunk-enheder med højt fiberantal og 48 til 576 fibre. Muliggør hurtig implementering i stor skala med reduceret arbejdskraft og minimale installationsomkostninger.
Se detaljer om MPO-trunks med højt fiberantalDe Tre Niveauer af SU Forbindelse
Niveau A: Server-til-Leaf
1.152 fibre pr. rack ved brug af trunks med højt fiberantal eller jumpere til at forbinde NVL72 noder til Leaf Switches.
Niveau B: Leaf-til-Spine
Aggregering af skinnejusteret trafik inden for SU ved brug af 1:1 ikke-blokerende links til compute.
Niveau C: Spine-til-Core
Skalering ud over SU til et centraliseret Core-område ved brug af trunks med højt antal.
Traditionel Patching (Punkt-til-Punkt)
- ✕Manuel kompleksitet: Kræver 9.216 individuelle patchkabler pr. 8-rack-blok.
- ✕Luftstrømsforhindring: Tætte kabelbundter blokerer for udstødningsveje for væskekøling.
- ✕Risikoprofil: Høj sandsynlighed for ‘krydsede skinner’ under manuel 1:1 patching.
- ✕Implementeringstid: 115+ timer for manuel routing og mærkning pr. SU.
Modulær Kabelføring med Højt Fiberantal
- ✓Plug-and-Play: Konsoliderer tusindvis af fibre i præterminerede 128F/144F/256F/288F/576F skræddersyede trunks.
- ✓Termisk optimering: Kabler med lille diameter maksimerer luftstrømmen i tætte racks.
- ✓Effektiv Vejføring: Konsoliderer 1.152 aktive fibre pr. rack i MPO-backbones med højt antal.
- ✓Installationsprofil: Hurtig implementering via præterminerede fabriksprøvede samlinger.
Aktiv Fiber Vækst: Node til Fuld SuperPOD
KablingskompleksitetSkalerbar Enhed Visualiseret
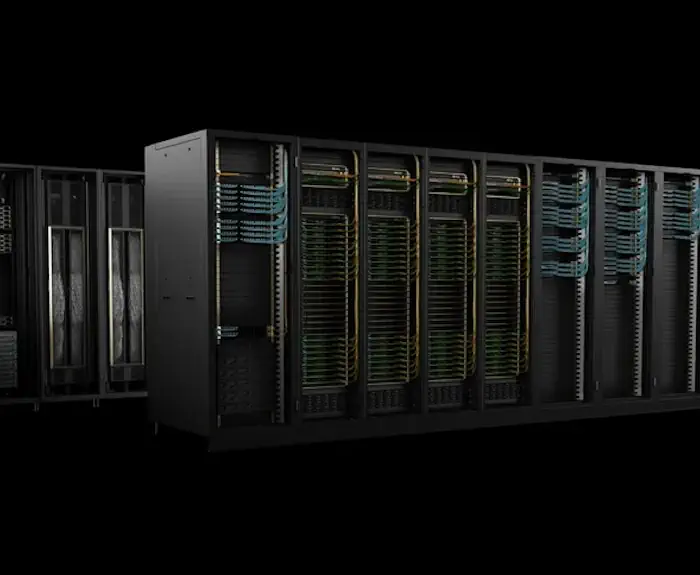
Den 8-Rack Compute Blok
En NVIDIA GB200 SU (Scalable Unit) består af 8 racks, hver med et DGX GB200 NVL72 system med 72 GPU’er.
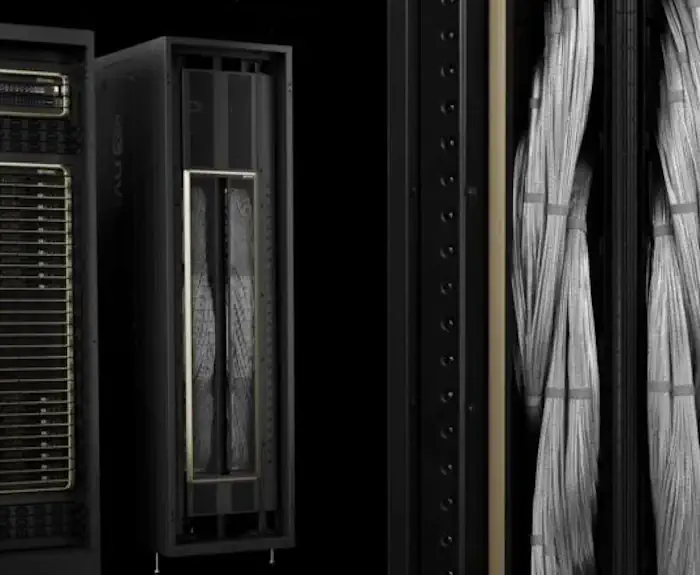
Distribution af Kabler med Højt Fiberantal
Konsolidering af tusindvis af rack-fibre i høj-densitets kabler for at sikre luftstrøm, hurtig installation og minimalt pladsforbrug.
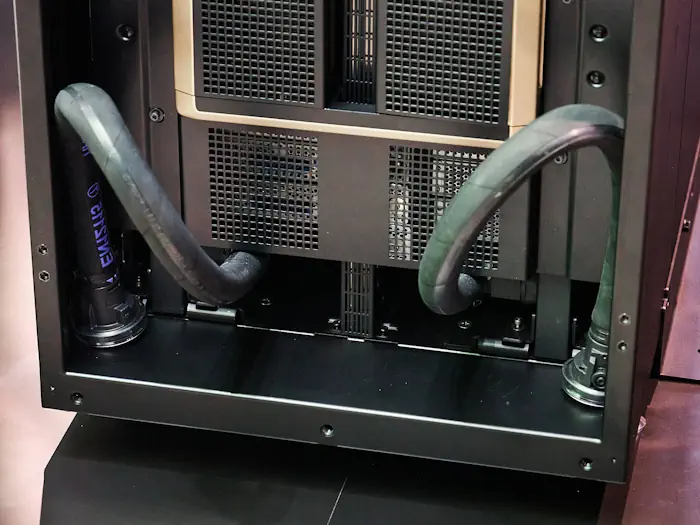
Væskekøling
Væskekølede koldplader stabiliserer bakke-miljøet, hvilket tillader OSFP transceivers at aflede varme effektivt via køleplader.
Teknisk FAQ
Design din AI-fabrik
ScaleFibre leverer præterminerede kablingsløsninger til NVIDIA DGX SuperPOD implementeringer.
Kontakt osFå detaljer om trunks med højt fiberantal til din NVIDIA DGX SU.